
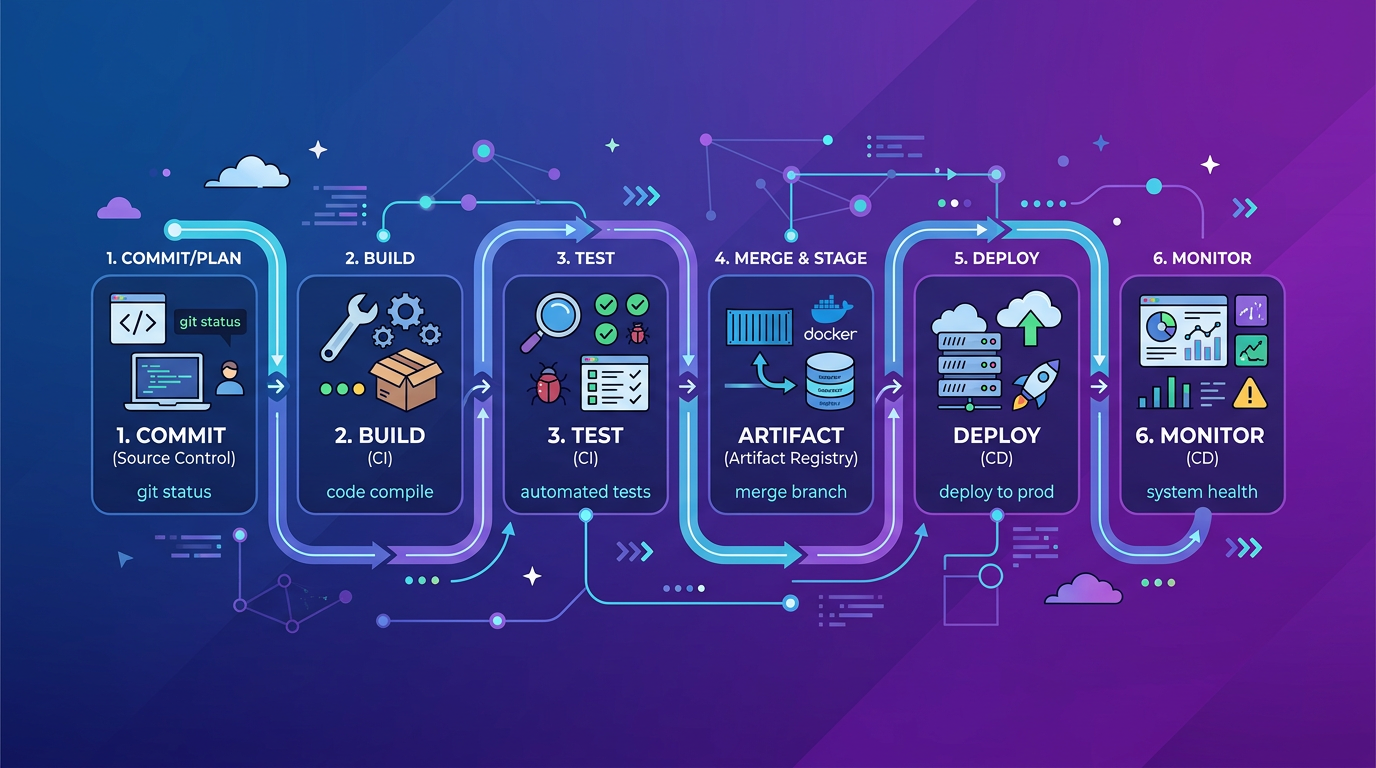
Prometheus+Grafana监控体系搭建
监控是运维的基石。没有监控的系统就像在黑暗中开车——你不知道什么时候会撞墙。Prometheus + Grafana是目前最流行的开源监控方案,支持数据采集、存储、查询、可视化、告警的全链路能力。
在云上环境中,监控告警与可观测体系的边界比传统机房更宽也更动态。「Prometheus+Grafana监控体系搭建」所讨论的实践,核心是把安全与可观测内建到日常流程里,而不是事后补救。
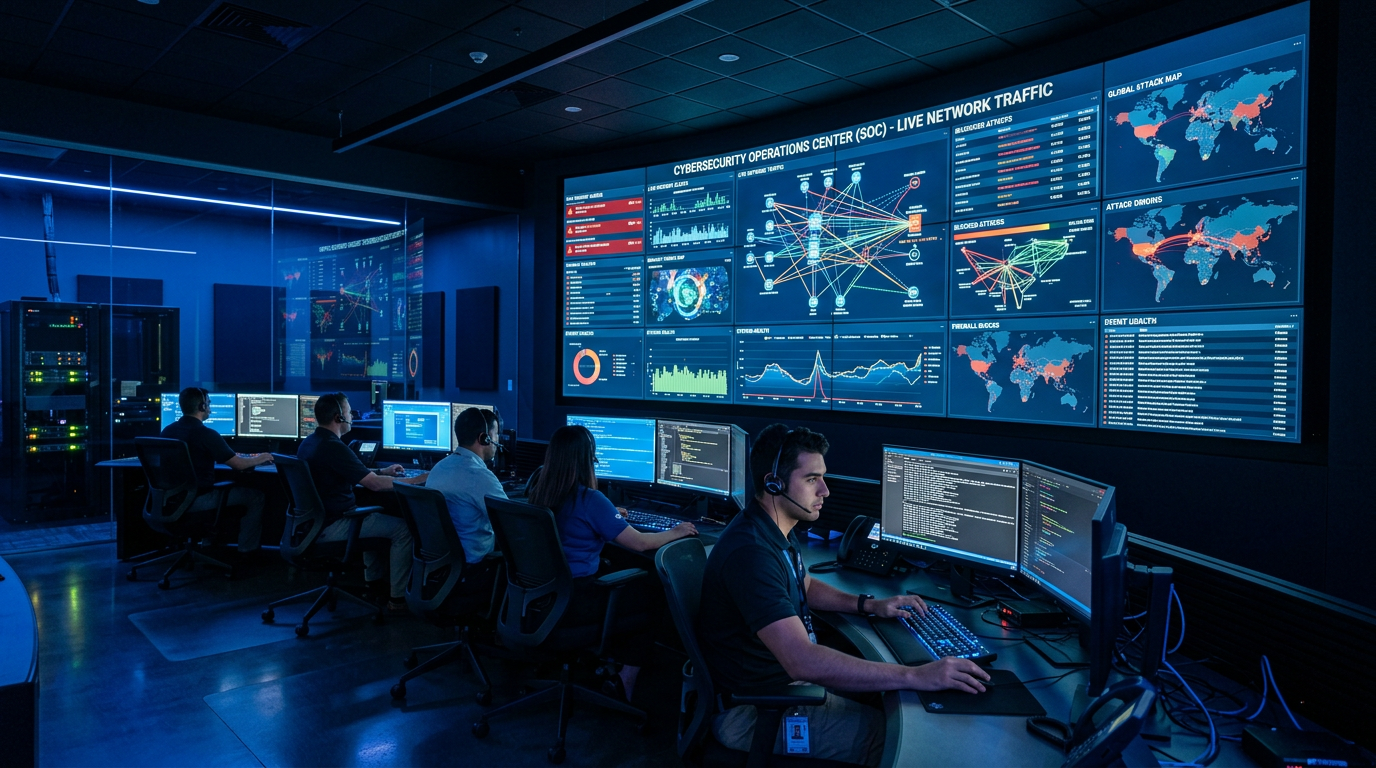
架构概览
Prometheus负责数据采集和存储。它通过HTTP协议定期从目标机器拉取(Pull模式)指标数据。Grafana负责可视化,连接Prometheus作为数据源,创建丰富的仪表盘。Alertmanager负责告警,接收Prometheus的告警规则触发通知。
部署方案
使用Docker Compose快速部署:Prometheus(端口9090)+ Grafana(端口3000)+ Alertmanager(端口9093)+ Node Exporter(采集主机指标,端口9100)。
prometheus.yml配置:定义scrape_interval(采集间隔,建议15s)、scrape_configs(采集目标)。添加Node Exporter作为第一个采集目标。
常用Exporter
- Node Exporter:采集Linux主机的CPU、内存、磁盘、网络指标
- MySQL Exporter:采集MySQL的性能指标(QPS、连接数、慢查询)
- Redis Exporter:采集Redis的内存、连接、命中率等
- Nginx Exporter:采集Nginx的请求量、响应时间、连接状态
- Blackbox Exporter:探测HTTP/TCP/ICMP的可用性和响应时间
- cAdvisor:采集Docker容器的资源使用指标
Grafana仪表盘
Grafana社区提供了大量现成的Dashboard模板。在Grafana → Import中输入模板ID即可导入。推荐模板:Node Exporter Full(ID: 1860)、MySQL Overview(ID: 7362)。
告警配置
在Prometheus中定义告警规则(alerting rules),如CPU使用率超过90%持续5分钟。Alertmanager接收告警后,根据路由配置发送到钉钉、邮件、Slack等渠道。支持告警分组、抑制、静默等高级功能。
一份可执行的日常清单
- 暴露面盘点:定期梳理对外端口与服务,关闭不必要的开放。
- 权限最小化:账号与密钥按最小权限分配,定期回收闲置权限。
- 告警治理:清理长期无人响应的告警,保证留下的告警都值得处理。
- 预案演练:对高频故障场景准备处置预案并定期演练。
清单不复杂,难在坚持;而监控告警与可观测体系的差距,恰恰体现在坚持上。
把监控告警与可观测体系交给更专业的协作方
安徽卓牛为客户提供云上的安全加固、监控体系搭建与运维托管服务,能够结合阿里云安全与可观测产品,帮助团队建立可持续的运维安全体系,而非一次性整改。
若你希望就「Prometheus+Grafana监控体系搭建」涉及的内容做一次现状评估,可通过官网在线客服联系安徽卓牛,获取针对性建议。