
读写分离后最头疼的是"刚写完立刻读,却读到了旧数据",根因就是主从延迟。
「MySQL 主从延迟排查与读写分离落地」是数据团队绕不开的现实课题。MySQL 与 RDS 性能治理不是一次性项目,而是伴随业务增长持续演进的过程,需要把性能、安全与成本放在同一个框架里长期权衡。
延迟来源
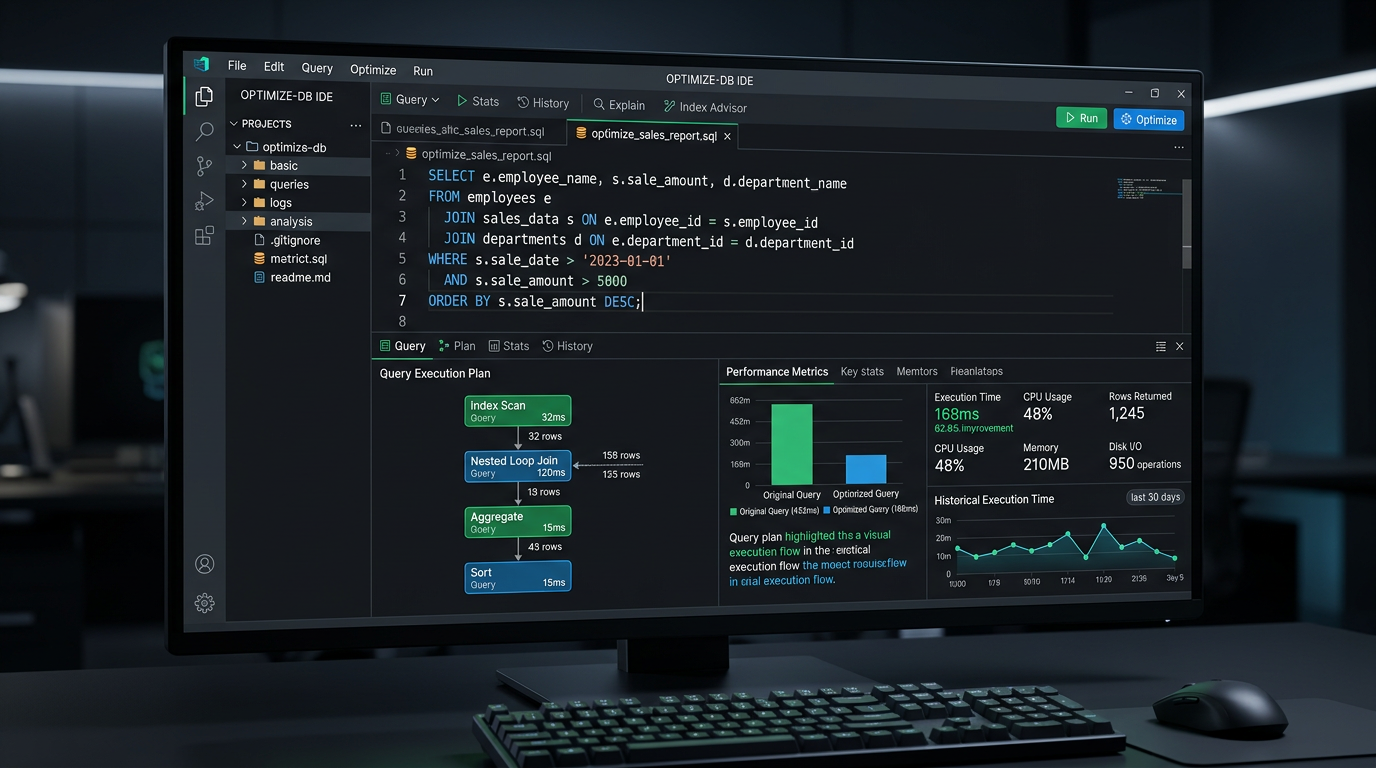
从库单线程重放大事务、从库负载过高、网络抖动、无索引的 SQL 在从库执行慢、以及大事务或 DDL,都会造成延迟。
排查
看 Seconds_Behind_Master 并结合实际数据比对;检查从库慢 SQL 与资源占用;定位是否有大事务。
优化
开启并行复制、拆分大事务、让从库的规格与索引和主库对齐、避免让从库承担过重的分析型查询。
业务侧规避
强一致读(写后立即读、关键校验)走主库,或做"会话内读主";能容忍最终一致的读才走从库。
中间件与代理
用 RDS 只读实例 + 读写分离地址,或代理层自动路由,并配置基于延迟阈值的节点摘除策略。
小结:读写分离要显式区分"哪些读能容忍延迟",别默认所有读请求都走从库。
延迟要有可观测的度量,路由要有可回退的降级
复制延迟指标只反映从库的回放进度,并不能完全代表业务感受到的延迟:它可能显示为很小的值,而某个大事务的数据其实还没落地。要让读写分离真正可靠,得有自己的度量手段与降级路径。
- 心跳表测真实延迟:主库定时写入一条带时间戳的心跳记录,从库读取并计算差值,得到的才是端到端的可见延迟,这个指标可以直接接入告警,比内置指标更贴近业务体感。
- 基于阈值的路由:延迟超过设定阈值时自动把读流量切回主库或摘除该只读节点,恢复后再逐步加回,避免用户长时间读到旧数据。
- 写后读走主库:下单后查订单、提交表单后展示结果这类场景,用会话级标记在一定时间窗内强制读主,比逐个接口手工判断更省心也更不容易漏。
- 并行复制的前提:开启并行复制能提升回放速度,但大事务与串行依赖仍会造成延迟,根本上还是要把大事务拆小、避免在业务高峰执行结构变更。
- 从库别当分析库用:把重查询、报表任务放到从库,会挤占回放资源、放大延迟;分析型负载更适合独立的分析实例或数据仓库。
上线读写分离前,建议先把接口按一致性要求分类并写进文档:哪些必须读主、哪些能容忍秒级延迟、哪些可以走缓存。这份清单比任何中间件配置都更能决定最终的稳定性,也是后续新人接手时最重要的参考资料。
从排查到预防:把经验沉淀为机制
- 慢的问题先定位再动手:用执行计划与监控数据说话,避免凭感觉改索引、改参数。
- 变更留痕:每一次调整记录原因与预期,便于复盘与回退。
- 容量预警前置:为存储、连接数、内存等关键水位设置提前量告警。
- 演练常态化:把恢复演练、切换演练纳入日常,而不是出事才第一次做。
机制化的沉淀,能让MySQL 与 RDS 性能治理从「个人经验」变成「团队能力」。
MySQL 与 RDS 性能治理的三个基本盘
其一是可恢复性:备份的价值不在于「做了」,而在于「能恢复」,定期演练恢复流程比增加备份份数更重要。其二是可回滚性:任何结构或参数变更都应有回退路径,避免把生产当试验场。其三是可预估性:容量与增长趋势要有数据支撑,而不是等到告警才响应。
这三个基本盘稳固之后,再去做性能调优和架构升级,风险会小很多。