
云监控告警体系搭建:及时发现和处理问题
监控系统是运维的"眼睛"。没有监控的线上系统就像蒙着眼睛开车——不知道什么时候会撞墙。阿里云提供了完善的监控产品体系,本文分享如何搭建一套覆盖全面、告警精准、处理高效的监控告警体系。
运维与安全工作的价值,常常体现在「什么都没发生」上。「云监控告警体系搭建:及时发现和处理问题」所涉及的监控告警与可观测体系,正是这种隐性价值的来源:体系健全时风平浪静,体系缺失时一次小问题就可能演变成大事故。
监控体系架构
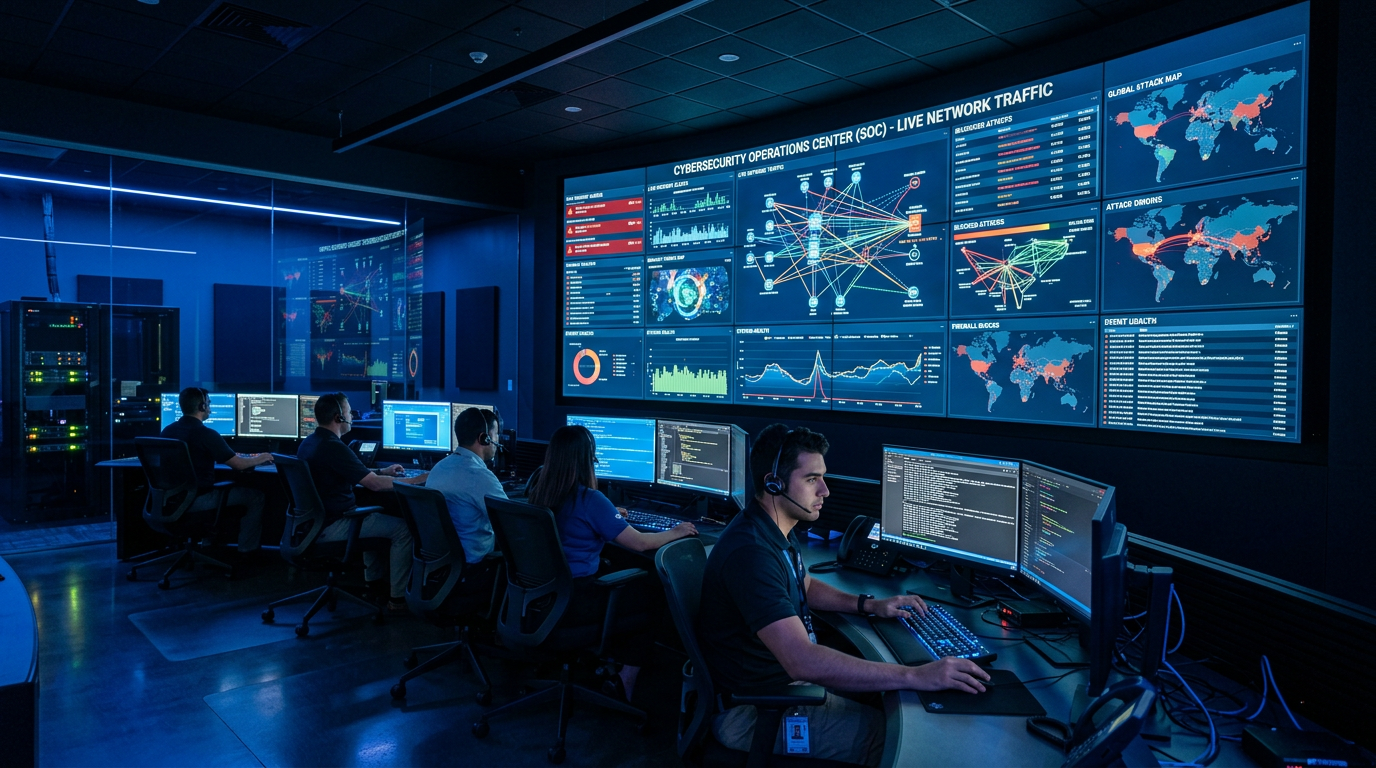
我们的监控体系分三层:
- 基础监控:阿里云云监控(CloudMonitor),自动采集ECS、RDS、Redis等云产品的指标(CPU、内存、网络、磁盘)。无需安装Agent,开箱即用。
- 应用监控:ARMS应用实时监控,自动发现服务拓扑、链路追踪、接口性能分析。支持Java、Go、Python、Node.js等多语言。
- 自定义监控:业务指标(订单量、支付成功率、注册用户数)通过云监控自定义监控上报,支持秒级粒度。
告警规则设计
告警规则设计的关键是分级:
P0(紧急):核心服务不可用、数据库连接数超过90%、磁盘使用率超过95%。通知方式:电话+短信+钉钉,7×24小时响应。
P1(重要):服务响应时间超过3秒、CPU持续超过80%超过10分钟、错误率超过5%。通知方式:短信+钉钉,工作时间15分钟内响应。
P2(一般):磁盘使用率超过80%、证书即将过期(7天内)、非核心服务异常。通知方式:钉钉+邮件,工作时间处理。
告警降噪
告警风暴是运维的噩梦——一个底层故障触发上百条告警。解决方案:
- 告警收敛:同一实例5分钟内的多条告警合并为一条通知
- 告警依赖:配置告警依赖关系,底层资源告警时抑制上层告警
- 告警升级:P0告警15分钟未处理,自动升级通知上级负责人
值班和故障处理
建立值班制度,工作日和周末轮流值班。值班人员收到告警后,按照预定义的故障处理手册(Runbook)操作。每个常见故障都有对应的处理步骤文档,新人也能快速处理。
监控告警与可观测体系的体系化思路
与其追求单点工具的极致配置,不如先保证覆盖面:关键资产是否都在监控之内、重要操作是否都有审计、对外暴露面是否都经过评估。覆盖面完整之后,再谈深度优化才有意义。
体系化的另一个好处是可传承:不依赖某个人的记忆,而是依赖流程与清单,团队整体水位才会稳定提升。
一份可执行的日常清单
- 暴露面盘点:定期梳理对外端口与服务,关闭不必要的开放。
- 权限最小化:账号与密钥按最小权限分配,定期回收闲置权限。
- 告警治理:清理长期无人响应的告警,保证留下的告警都值得处理。
- 预案演练:对高频故障场景准备处置预案并定期演练。
清单不复杂,难在坚持;而监控告警与可观测体系的差距,恰恰体现在坚持上。