
SLB后端ECS健康检查失败排查
SLB健康检查一直显示失败,ECS被反复摘除和恢复,业务受到严重影响。本文提供完整的排查清单。
不少团队在「SLB后端ECS健康检查失败」上走过弯路,根源通常是只优化了局部、却忽视了全局。负载均衡与流量调度的价值恰恰体现在端到端的协同:从资源申请、网络互通,到弹性与容灾,每一步都需要统一的规范和口径。
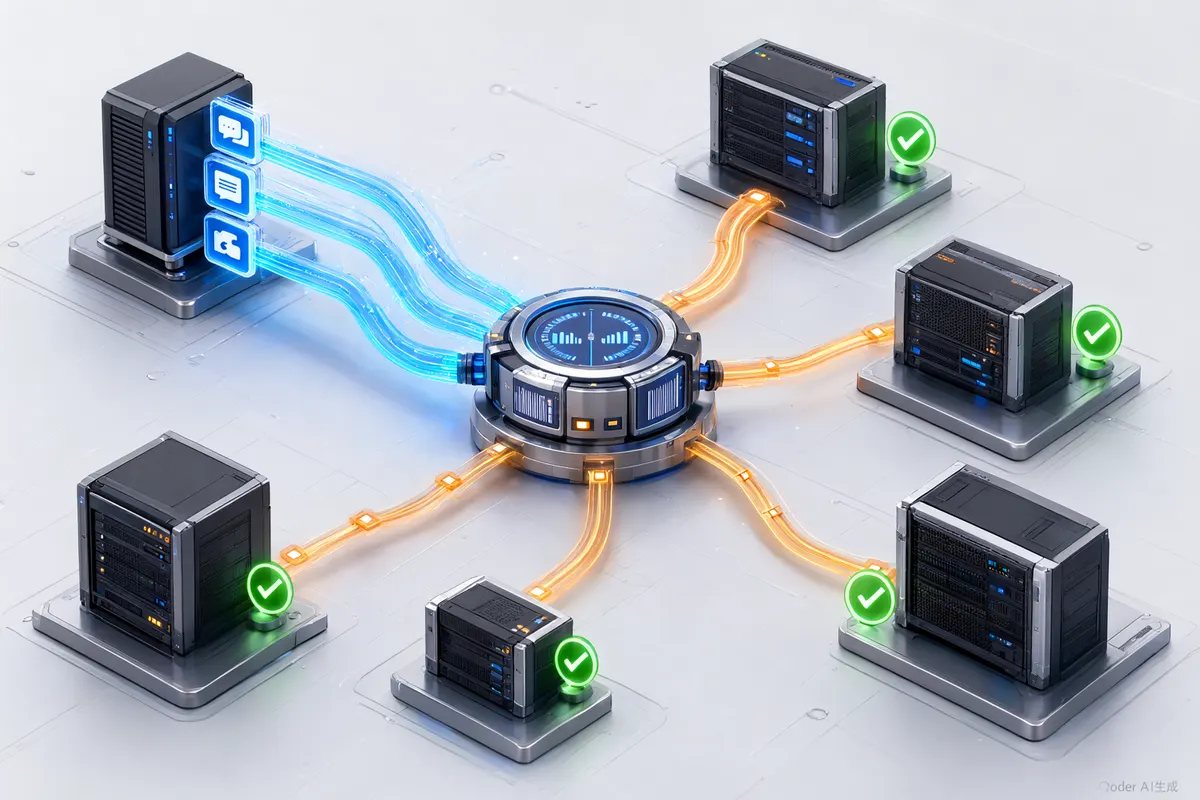
排查清单
1. 安全组:SLB健康检查使用100.64.0.0/10网段。确认后端ECS的安全组入方向允许来自这个网段的访问。这是最常见的原因!
2. 服务是否监听正确端口:netstat -antlp | grep 端口号。确认应用确实在监听SLB配置的端口。
3. 健康检查路径:七层检查默认请求 /。如果首页需要登录或响应很慢,建议创建专用的 /health 接口返回200。
4. 响应状态码:七层检查只认2xx和3xx。如果应用返回301重定向到HTTPS,健康检查会认为失败。
5. 响应时间:健康检查超时时间默认5秒。如果应用响应超过5秒,检查失败。优化应用性能或增大超时时间。
6. iptables:后端ECS的iptables可能拦截了SLB的探测请求。临时关闭iptables测试。
快速验证
在后端ECS上用curl模拟SLB的健康检查:curl -v http://localhost:端口/健康检查路径。如果本地curl都失败,说明是应用问题。如果本地成功但SLB检查失败,说明是网络/安全组问题。
健康检查参数怎么配才不会误摘
健康检查的配置目标有两个:后端真出问题时尽快摘除,后端只是短暂抖动时不要误摘。两者靠参数组合平衡,而不是靠单一阈值。
- 检查路径:选轻量且能反映真实依赖的接口,避免用会重定向的首页,也避免用依赖多个外部服务的聚合接口,否则健康检查本身成了故障源。
- 间隔与阈值:检查间隔、健康/不健康判定次数共同决定摘除与恢复速度;超时时间要小于间隔,否则请求会排队堆积。
- 网络放行:健康检查源地址段必须在安全组内放行,很多「后端明明正常却被摘」的问题都出在这里。
- 判定语义:返回码判定要与业务一致(重定向算不算健康、维护页返回什么码),别用默认值糊过去。
最后两点容易被忽略:后端被摘除要有告警,不能等用户报障才发现;以及「全部后端不健康时是否继续转发」的策略要提前确认,这个开关在极端场景下决定了是全站不可用还是带病服务。
与安徽卓牛一起推进负载均衡与流量调度
安徽卓牛作为阿里云一级代理商,长期服务企业客户的上云与用云全过程,能够围绕负载均衡与流量调度提供架构评审、产品选型、迁移实施与运维托管等一站式支持,帮助团队把精力集中在业务本身。
如果你正在评估「SLB后端ECS健康检查失败」相关方案,或希望对现有架构做一次体检,欢迎通过官网在线客服联系安徽卓牛,获取贴合自身业务的建议。
把负载均衡与流量调度放回架构全局来看
单点的最优解,叠加起来未必是全局最优。评估负载均衡与流量调度时,建议先明确业务的峰值模型与故障容忍度,再倒推资源与网络该怎么设计:哪些负载是稳定基线、哪些是突发流量、哪些可以容忍短暂中断,答案不同,架构取向也完全不同。
在此基础上再谈规格与参数,才有意义。否则很容易陷入「先买资源、再找用途」的被动局面,成本与复杂度都会随之上升。